La data et le recrutement : compte rendu meetup OpenSourcer
Le décor
Le 4 novembre 2026, nous étions une trentaine réunis chez Ideuzo (merci encore à Olivier et Tanguy de nous ouvrir leurs portes), pour cette troisième conférence du meetup OpenSourcer.
Au menu, La data et le recrutement : Patrick Dos Santos, expert en talent acquisition, une dizaine d’années de métier derrière lui, nous présentait sa vision et sa philosophie autour de la data et de l’évolution de notre métier vers la data analyse.
Il n’a pas présenté d’outil. Il a présenté une philosophie, des fondamentaux et une architecture. Et il a commencé par retirer à la salle le mot dont elle est le plus fière : Data Driven !
Sa thèse tient en une ligne, et la soirée entière l’a déroulée : nous travaillons dans la couche brute d’une chaîne dont nous ne possédons aucun étage, et pour autant, on nous juge sur le dernier.
Quatre conditions, et les quatre tombent
Première question à la salle : qui travaille dans une organisation data driven ? Deux ou trois mains. Il creuse, et il retourne la réponse : ces organisations sont KPI driven et non pas data driven.
Le modèle vient des cabinets et des équipes commerciales. Il installe des réflexes de pilotage sur une matière qui ne les supporte pas.
Le volume. Une équipe qui approche la trentaine de recrutements par an est déjà une bonne équipe. Pour autant, une grossesse, les vacances d’août, un mois de mai truffé de jours fériés, font bouger les lignes de 25%. Une statistique ne vaut que représentative : à 300 ou 500 recrutements, elle peut l’être. En dessous, on ne pilote pas une activité, on raconte une histoire.
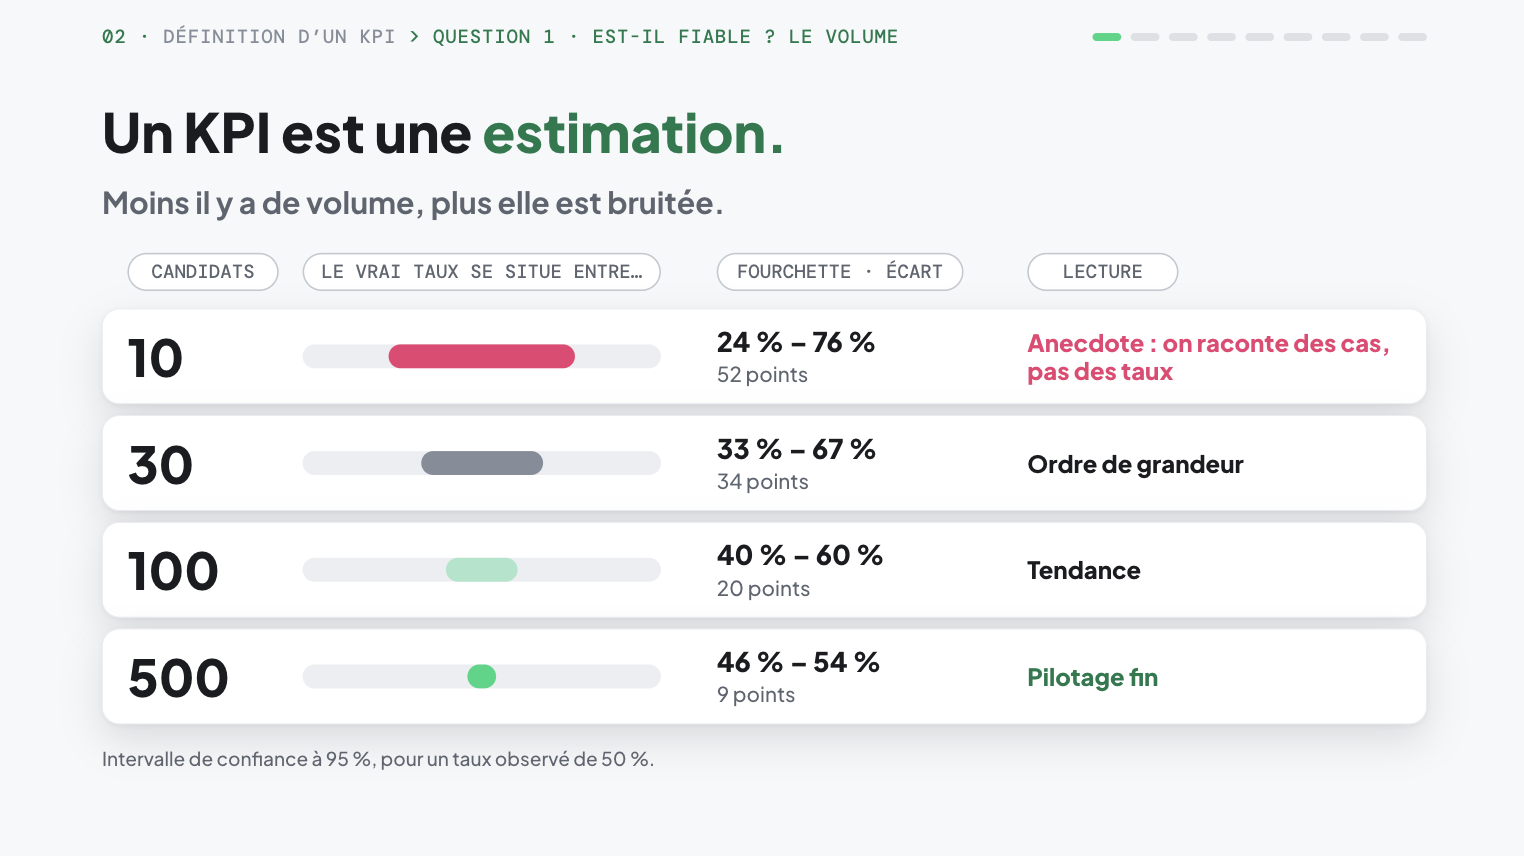
Sur dix candidats, un taux observé à 50% peut valoir n’importe quoi entre 24% et 76%. Il faut cinq cents observations pour piloter finement.
La méthode de calcul. Moyenne, médiane, Pareto, percentile : ceux qui arbitrent savent-ils les distinguer, et que vaut l’arbitrage quand deux services annoncent deux chiffres sur le même objet ?
Le benchmark ne vaut que s’il compare des unités comparables, or cela suppose des définitions communes, un même marché, une même marque employeur. Et un même sens : un time to hire qui gagne trois jours, qu’est-ce que ça change à l’activité ?
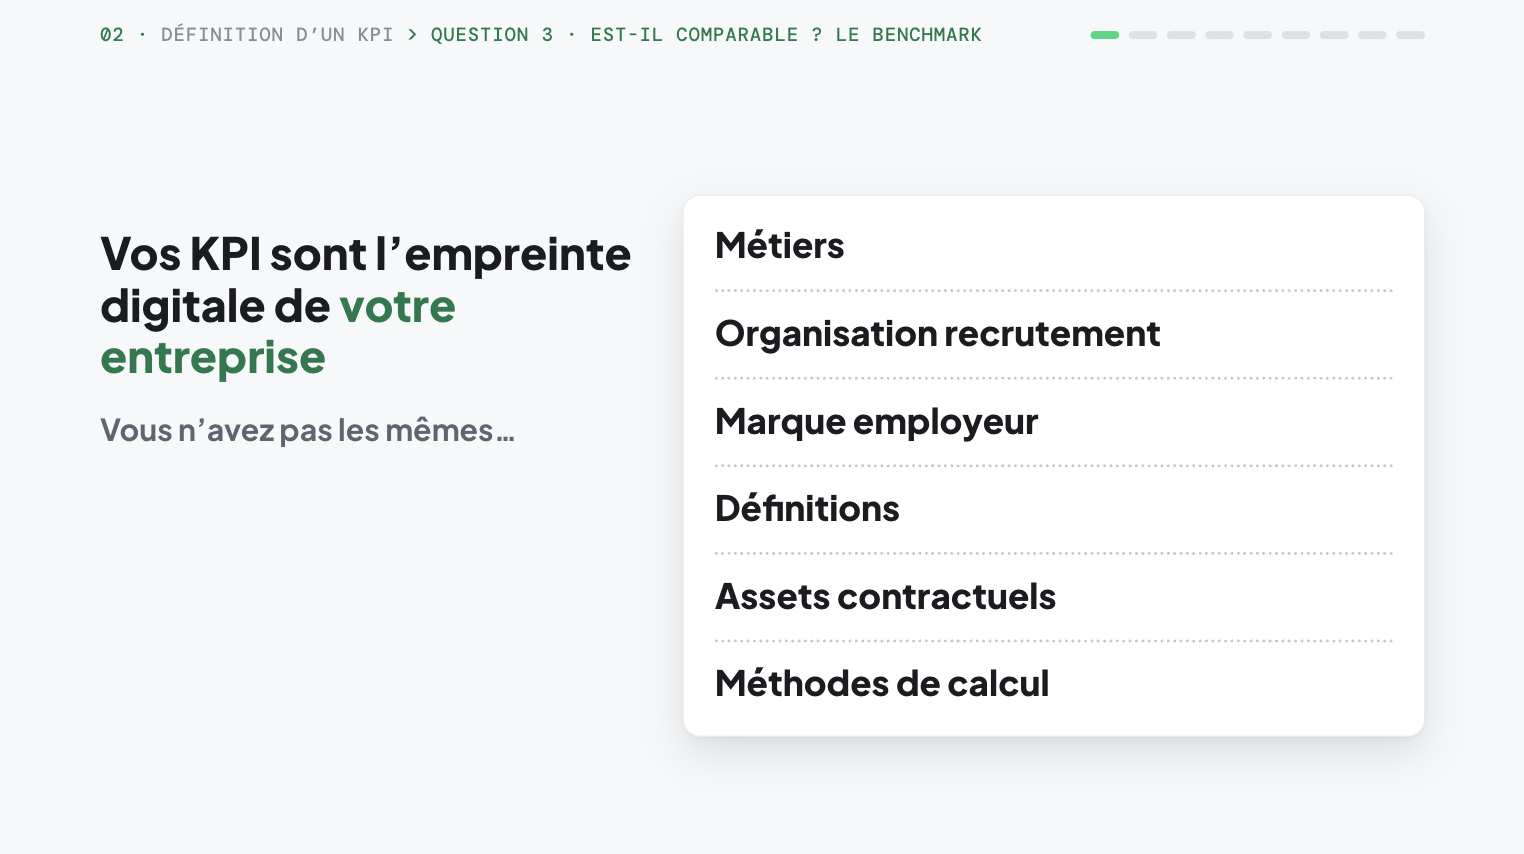
Métiers, organisation du recrutement, marque employeur, définitions, engagements contractuels, méthodes de calcul : six raisons pour lesquelles deux entreprises ne mesurent pas la même chose.
Quand une mesure devient un objectif, elle cesse d’être une mesure. C’est la loi de Goodhart.
Le recrutement tel qu’on le pratique est piloté par des objectifs chiffrés, construits sur des indicateurs qui auraient dû rester des alertes. Le KPI n’est pas faux pour autant. C’est un regard rétrospectif sur une période, flou sur de petits volumes, aveugle dès qu’on agrège. Pour voir net, il faut redescendre à la donnée.
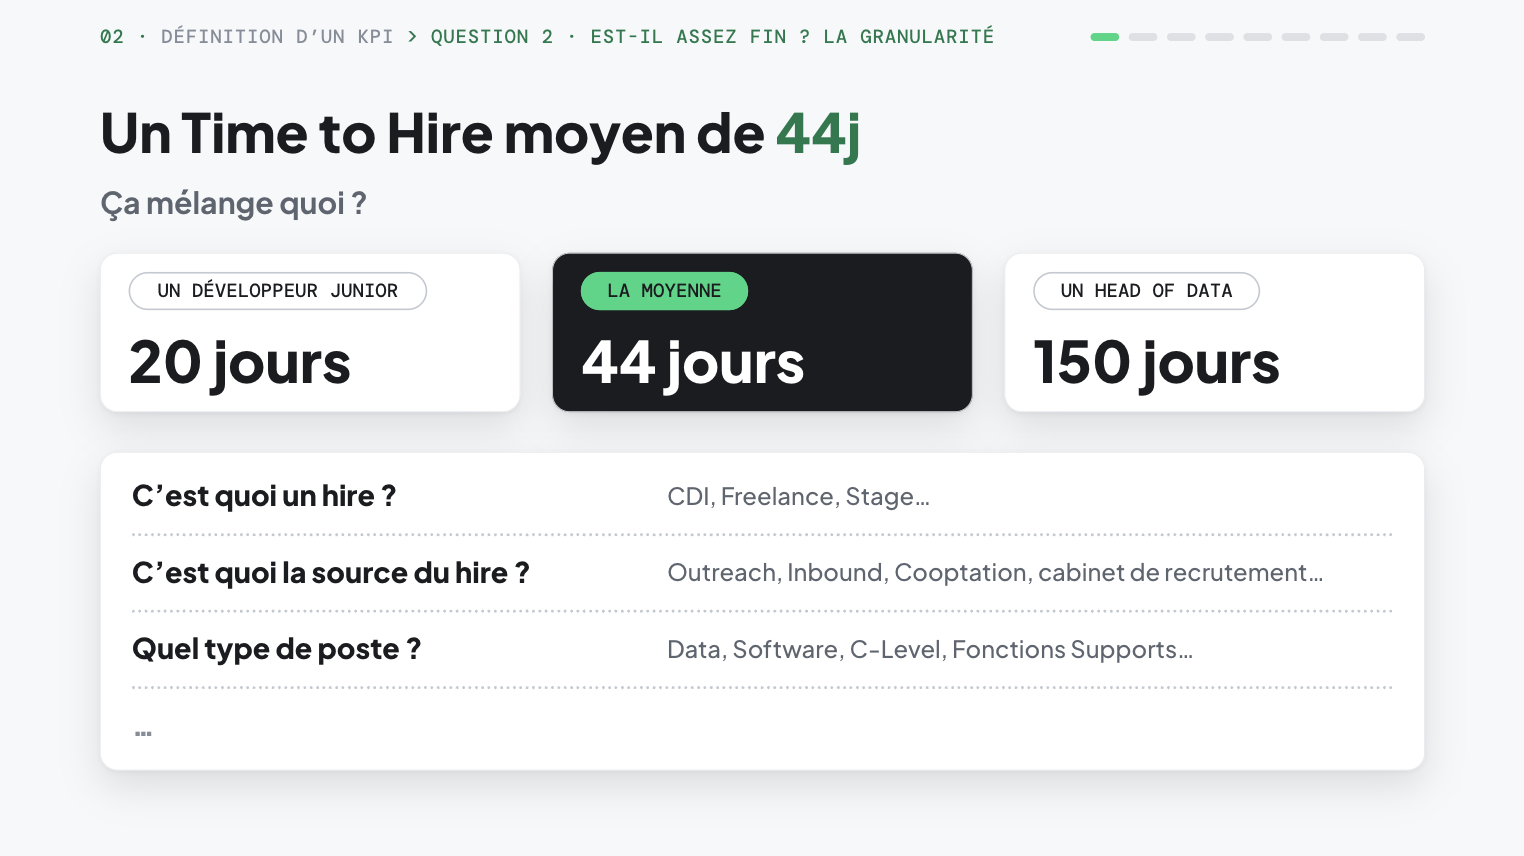
44 jours de time to hire en moyenne, c’est 20 jours pour un développeur junior et 150 pour un head of data.
Il ne jette donc pas la mesure, mais il en montre sa limite, selon la façon dont on la considère ou l’envisage. Pour cela il recourt au basket en prenant l’exemple du joueur Russell Westbrook. Russell tente sept tirs à trois points par match avec 30% de réussite, quand la ligue en tente quatre à 37%. L’indicateur dit : travaille ton shoot, et il peut s’entraîner comme un forcené sans que rien ne bouge. La donnée dit autre chose : le trois points n’est pas son registre. Dès lors, l’indicateur désigne une zone. La donnée dit quoi faire.
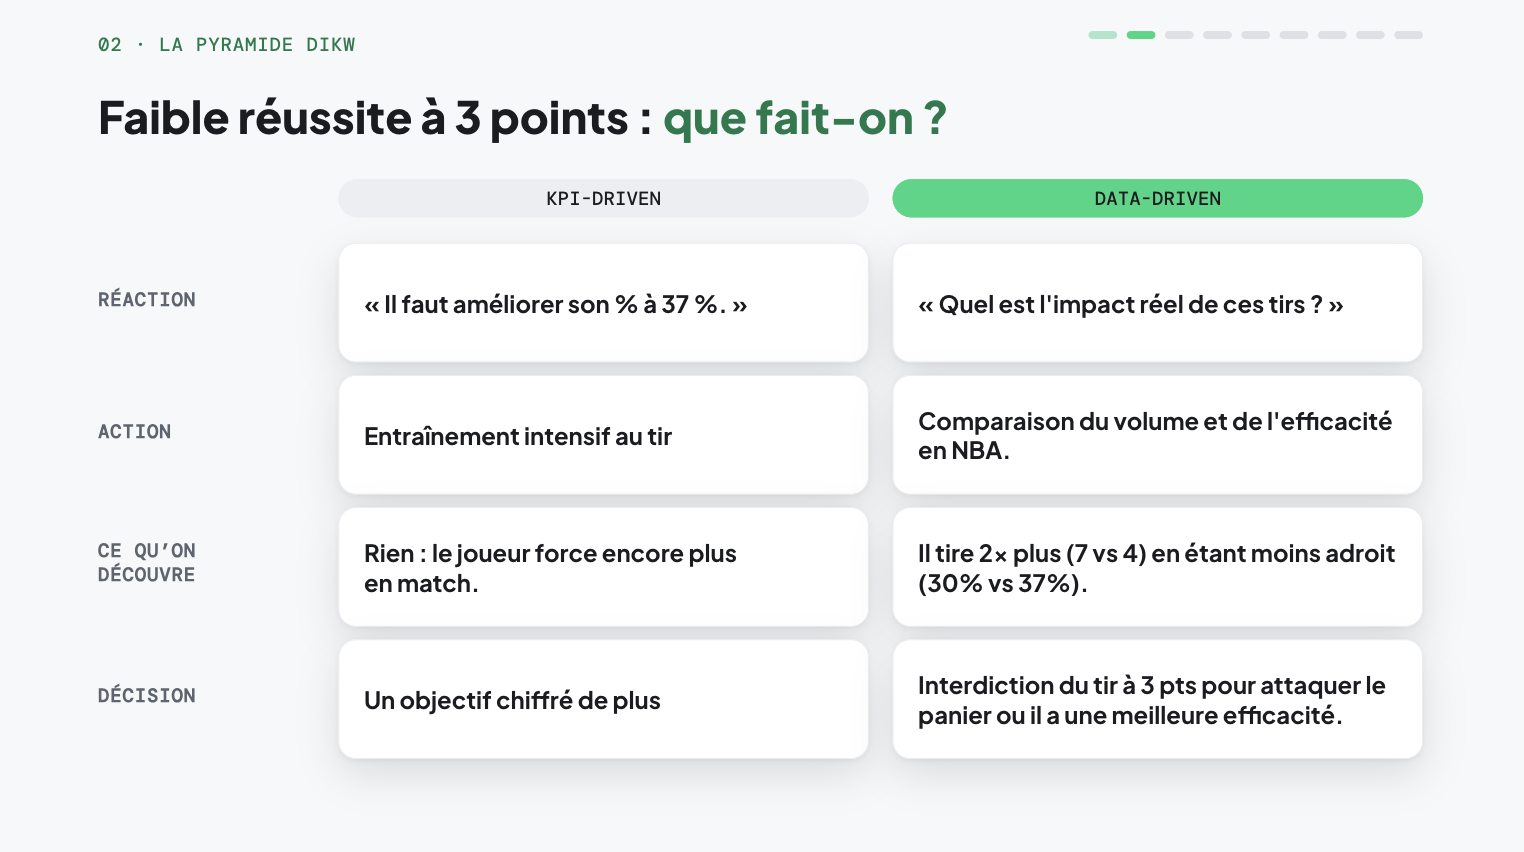
La lecture KPI envoie Westbrook s’entraîner au tir. La lecture data lui interdit le tir à trois points et l’envoie attaquer le panier, où il est meilleur.
Nous travaillons (même pas) dans le bronze, on nous juge sur l’or
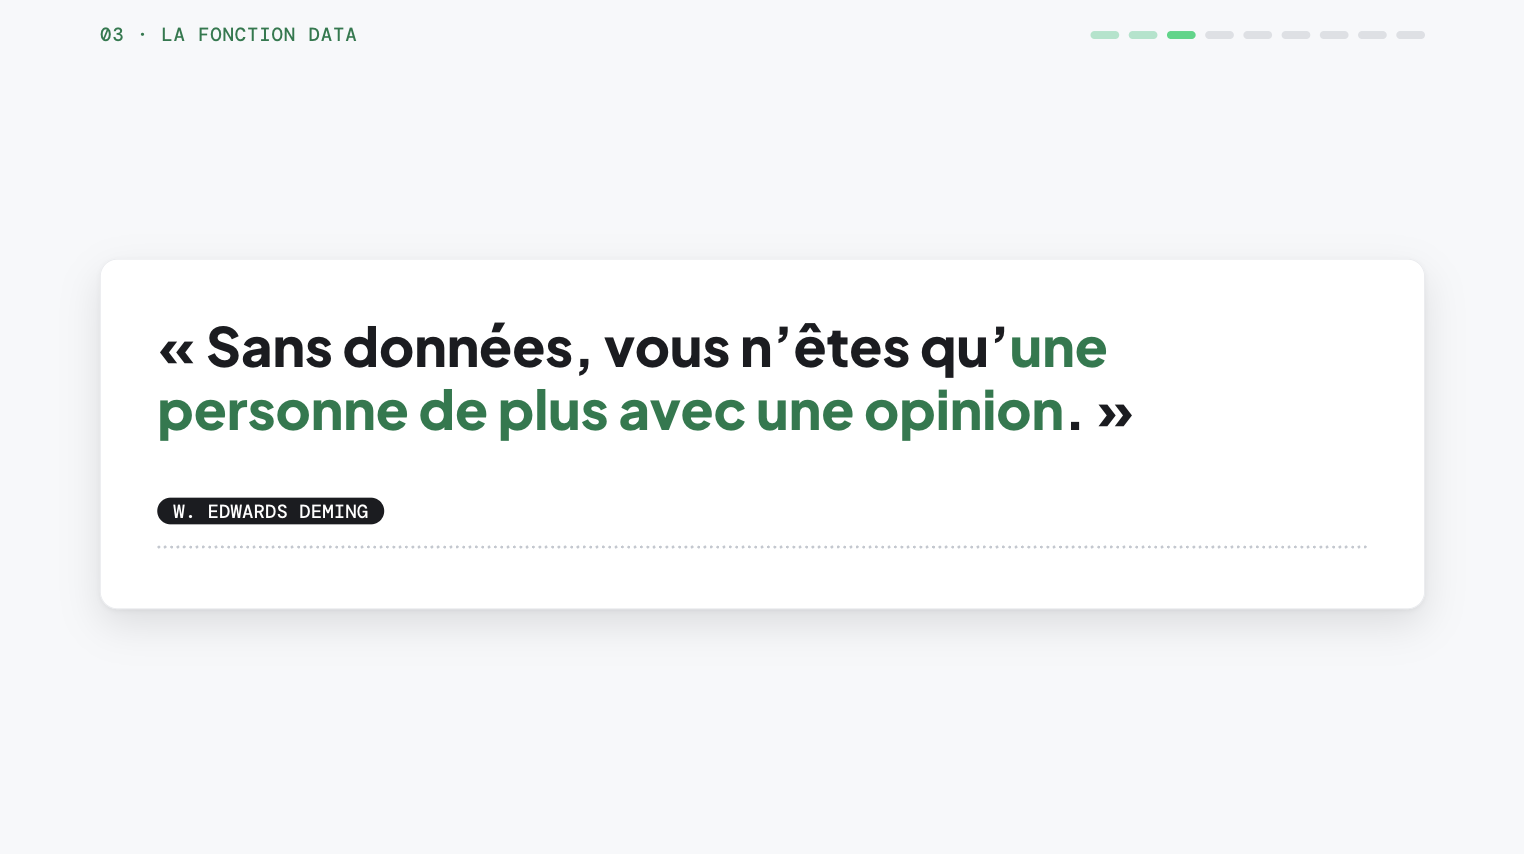
La phrase est de W. Edwards Deming. Il la pose avant d’ouvrir l’architecture.
Patrick reprend l’architecture médaillon, un standard des plateformes data, et il la pose sur le recrutement. Trois étages, entre les sources en amont et l’exploitation métier en aval.
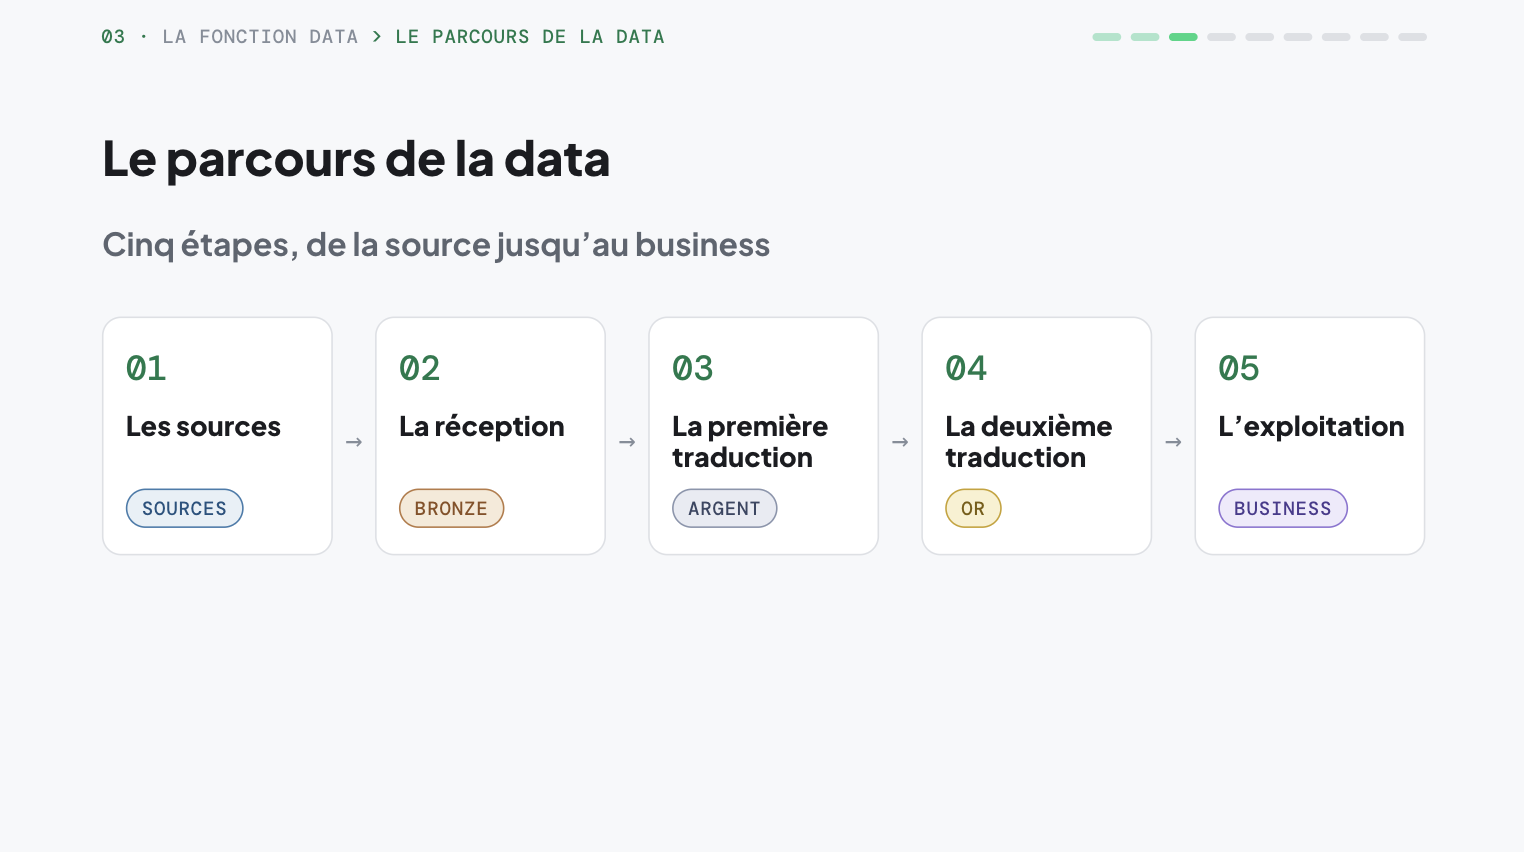
Les sources, la réception en bronze, la première traduction en argent, la deuxième en or, puis l’exploitation métier.
Le bronze, c’est le brut. On tire les flux, on stocke, on ne traite rien, parce que stocker ne coûte presque rien. Ce qu’on y gagne : la propriété de la source, la trace de son origine, le droit d’évoluer et de se tromper, puisqu’un traitement raté se rejoue depuis là.
L’argent, c’est le référentiel commun. On standardise, on nettoie, on dédoublonne : les formats de date d’une source LinkedIn, d’un profil GitHub et d’un CV ne sont pas les mêmes, et c’est ici que plusieurs sources convergent vers une seule personne. C’est là que naît le profil 360, tous les angles par lesquels on peut atteindre une même personne. Kathy Baptista en avait fait son sujet en avril.
L’or, c’est l’exposition au métier : fiches candidat, cartographies, tableaux de bord, définitions prêtes à l’emploi. L’étage où le recruteur rencontre le business et les managers.
Malheureusement, c’est là qu’on le juge, sur cette exposition : les fiches qu’il remet, les cartographies qu’il présente, les chiffres qu’il annonce. Son travail, lui, se fait dans le bronze, pire encore, dans des sources qu’il ne maîtrise pas. Il tape directement dans des plateformes qui n’ont pas été conçues pour le recrutement, sur de la donnée clairsemée, sans aucune standardisation en amont. Et le jour où une couche argent lui est fournie, c’est celle d’une solution tierce : il hérite de ses profils, de ses définitions, de ses seuils. La séniorité qu’elle lui renvoie n’est pas celle qu’il aurait écrite.
Qu’est-ce qu’un profil sénior pour vous ? J’ai ma réponse. Vous avez la vôtre, et le modèle a la sienne.
Quand l’incongruence d’un résultat vient de sources et de filtres non maîtrisés
C’est de cette dépendance et de ce constat que viennent sa lecture des solutions de sourcing IA. Elles l’abstraient de la partie du métier la plus sous-estimée, le sourcing, et elles l’enferment dans leur source : il reste bloqué en amont de la chaîne, et il quitte la première source mondiale pour rester, même pas, en bronze, avec des définitions moyennes, les mêmes pour tous. Il ne nomme aucun éditeur et pointe quatre pertes.
La capitalisation : tant qu’on reste dans la source d’un tiers, on ne peut pas traiter la donnée, donc pas l’enrichir, donc pas avancer avec plus d’informations qu’au départ. Et le jour où la source se ferme, le travail fait dessus n’existe plus.
La fraîcheur : ce sont souvent les mêmes profils que sur LinkedIn, mais pas à jour, parce que rafraîchir coûte cher et que l’éditeur ne fait que consommer la donnée de son fournisseur. Il achète à des revendeurs, qui achètent ailleurs. Une donnée dont on est propriétaire se rafraîchit quand on veut, selon ses propres règles, sans attendre personne. Celle-là, non.
Le déterminisme : la même requête ne rend pas la même liste deux fois, parce que le modèle la réinterprète à chaque passage, et parce que la sémantique sur laquelle il travaille n’est pas la vôtre. On retombe sur la définition du sénior.
La conformité, enfin, souvent affichée plutôt que construite, comme la gouvernance de la qualité : les règles de recherche restent inconnues, et l’opacité porte aussi sur la part du marché couverte. Son conseil est très concret : ouvrir l’inspecteur de son navigateur sur certaines solutions qui se déclarent conformes, et regarder ce que leur code envoie, et où.
Au bout de la chaîne, ce qui remonte, c’est la liste des profils les plus complets, pas celle des meilleurs. Reste la question de la valeur ajoutée : pousser une liste de profils évidents ?
D’où un point qui peut surprendre après cette charge. Ce qui l’agace tout autant, c’est le discours inverse, celui qui invite à quitter LinkedIn. Il préfère mettre le peu d’euros dont il dispose sur LinkedIn plutôt que sur une solution alternative, et il le justifie : LinkedIn existera encore dans un an, et la conformité y est tenue par des gens solides, là où les alternatives n’offrent ni visibilité sur la part du marché qu’elles couvrent, ni garantie sur la qualité de ce qu’elles renvoient. Il ne propose donc aucune source de rechange. Il veut seulement ne pas dépendre des filtres, de l’algorithme et des prix de celle qu’il utilise.
Reste le plus grave, et il se joue avant l’outil. Coller sa fiche de poste dans un modèle, c’est lui transmettre la demande telle qu’on l’a reçue en croyant avoir formulé une recherche : une fiche de poste est une requête, pas un contexte. Le langage naturel fait le reste, en mettant un outil d’interrogation dans les mains de gens dont ce n’est pas le métier, et Patrick y voit le piège déjà vu du self-service en data analyse. Un intake sale ne donne pas seulement un résultat sale : il le donne dégradé, et la dégradation s’empile à chaque étage.
Son calcul tient en quatre coefficients. Le besoin réel vaut 100. Le brief qui en descend en retient 80%, parce qu’un manager part du principe que vous avez déjà le reste. Le recruteur en comprend 80%, et il le dit sans ménagement, la plupart ne comprennent pas les briefs. L’IA, lancée sur du bronze, se trompe à trois endroits, compréhension, invention, stabilité, ce qui laisse 73% de justesse. Et la donnée candidat, mal renseignée, périmée ou enrichie à l’IA sans vérification, n’est fiable qu’à 80%. Reste 37% du périmètre réellement travaillé, et il précise qu’il a été gentil. Ça ne s’additionne pas, ça se multiplie.
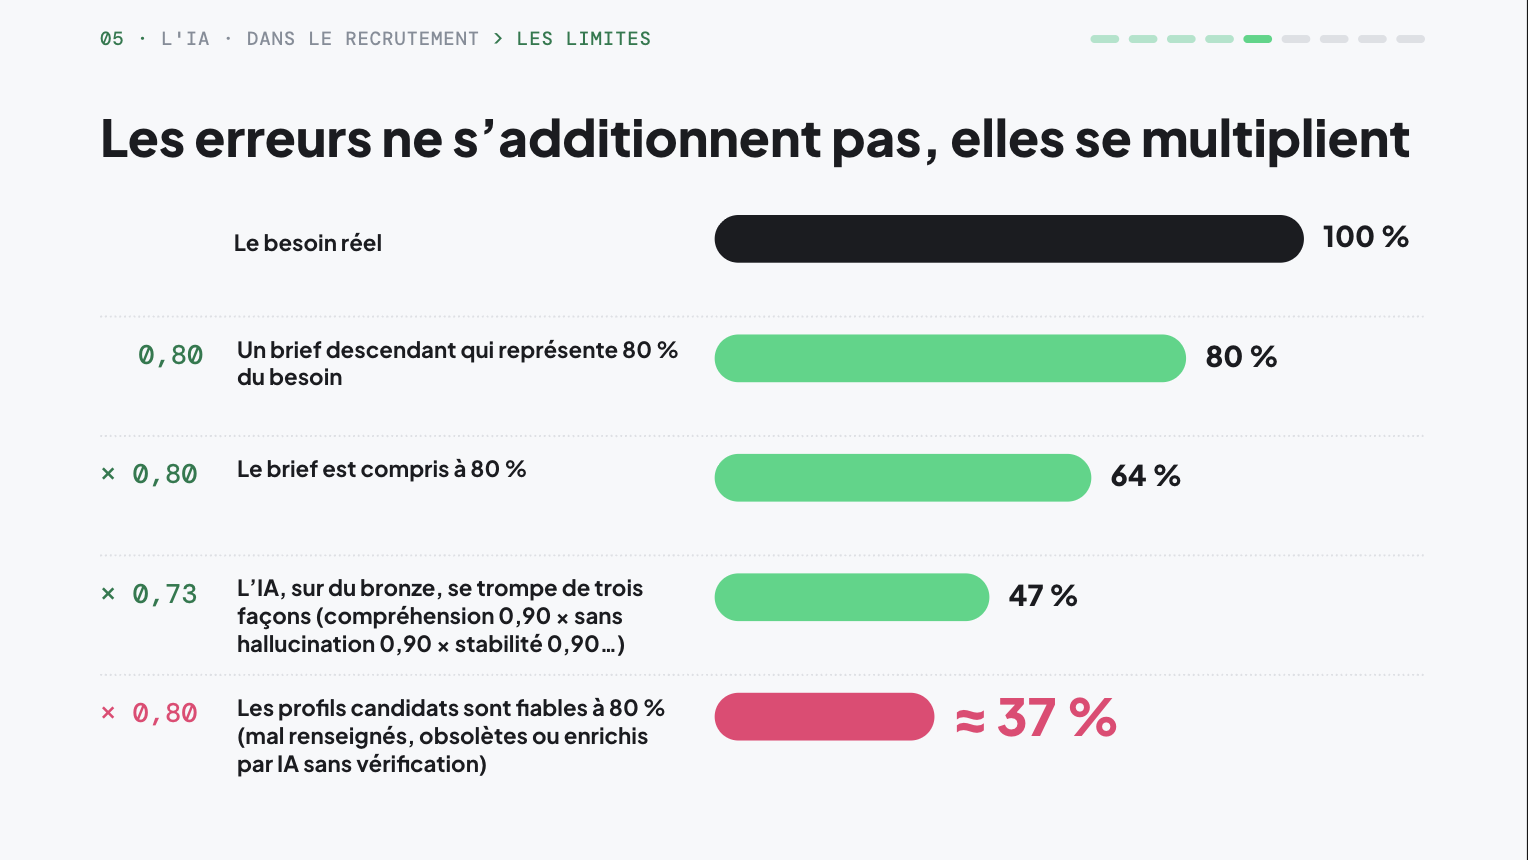
La chaîne, coefficient par coefficient : 0,80 × 0,80 × 0,73 × 0,80.
Garbage in, gospel out. On part du principe que si l’IA donne une réponse, c’est la bonne.
Dans un de mes derniers articles, je relevais que l’expérience actuelle d’un profil LinkedIn n’est renseignée que dans quatre cas sur dix, et ces quatre dixièmes sont la part qui veut être vue, puisqu’un réseau social promeut l’actif. Sur une niche, on passe à côté des deux tiers du vivier. On cherche des mots clés qui en fait sont absents dans 60% des cas et on l’ignore car on obtient toujours une réponse et c’est précisément le problème. Car nous ne savons pas comment s’est construite la réponse.
Ce qu’il y a à construire
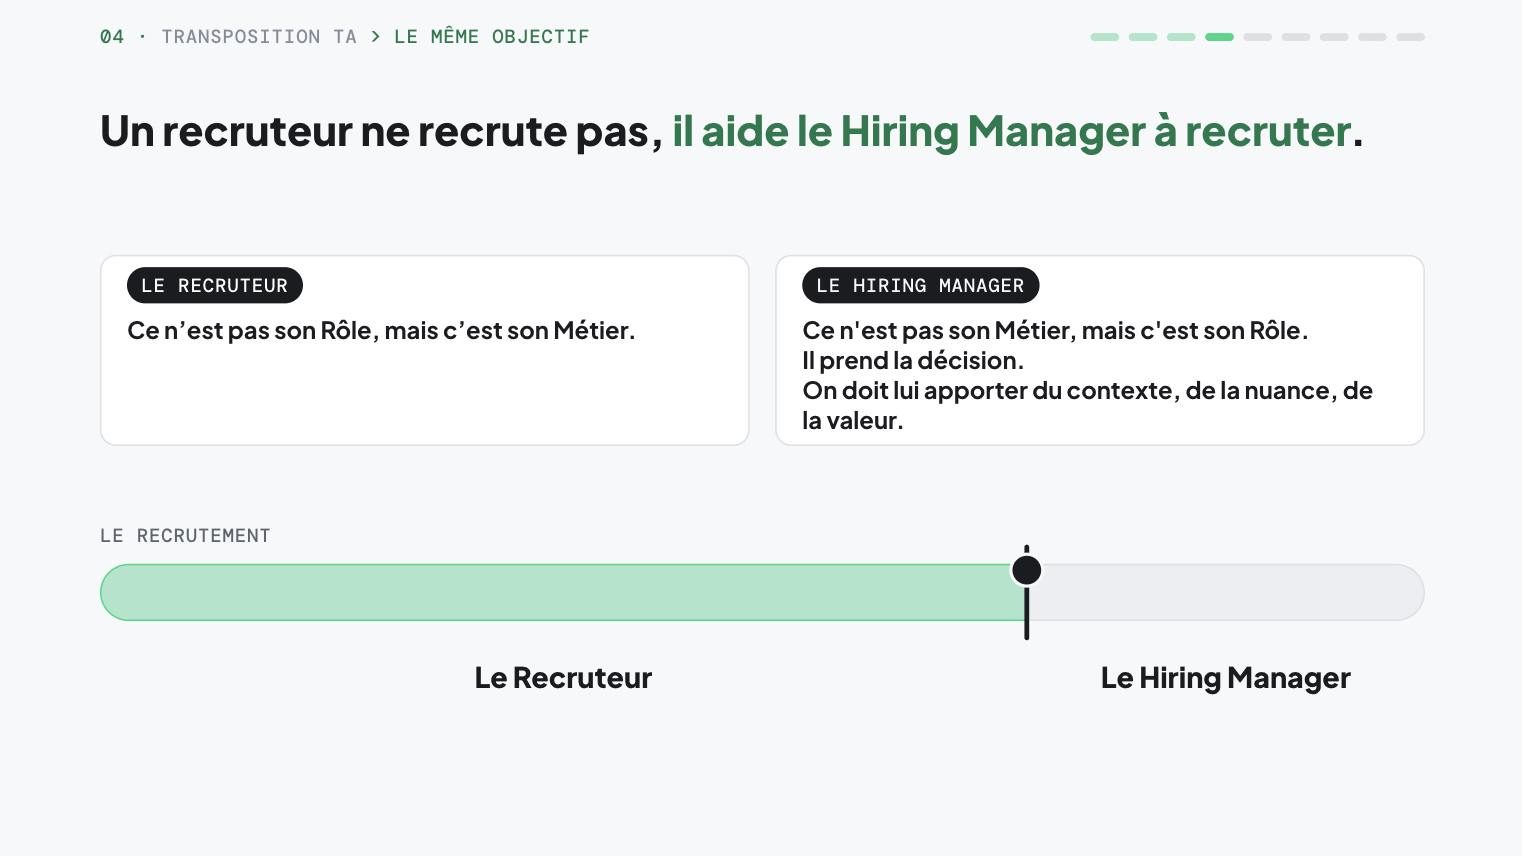
Le recruteur a le métier, le hiring manager a le rôle et prend la décision. Ce qu’on lui doit : du contexte, de la nuance, de la valeur.
Avant la méthode, la transposition. Patrick découpe la fonction en cinq rôles. Le recrutement transforme un besoin en décision. Le sourcing, qu’il rattache au growth, identifie les sources qui ont de la valeur et la façon de les exploiter. Le talent engineering construit le système, l’architecture de la donnée et le knowledge commun. Le RecOps optimise les process et l’outillage opérationnel. La talent intelligence matérialise la connaissance du marché des talents. Les trois qu’il désigne comme les métiers à enjeu sont l’expert sourcing, le talent engineer et l’analyste talent.
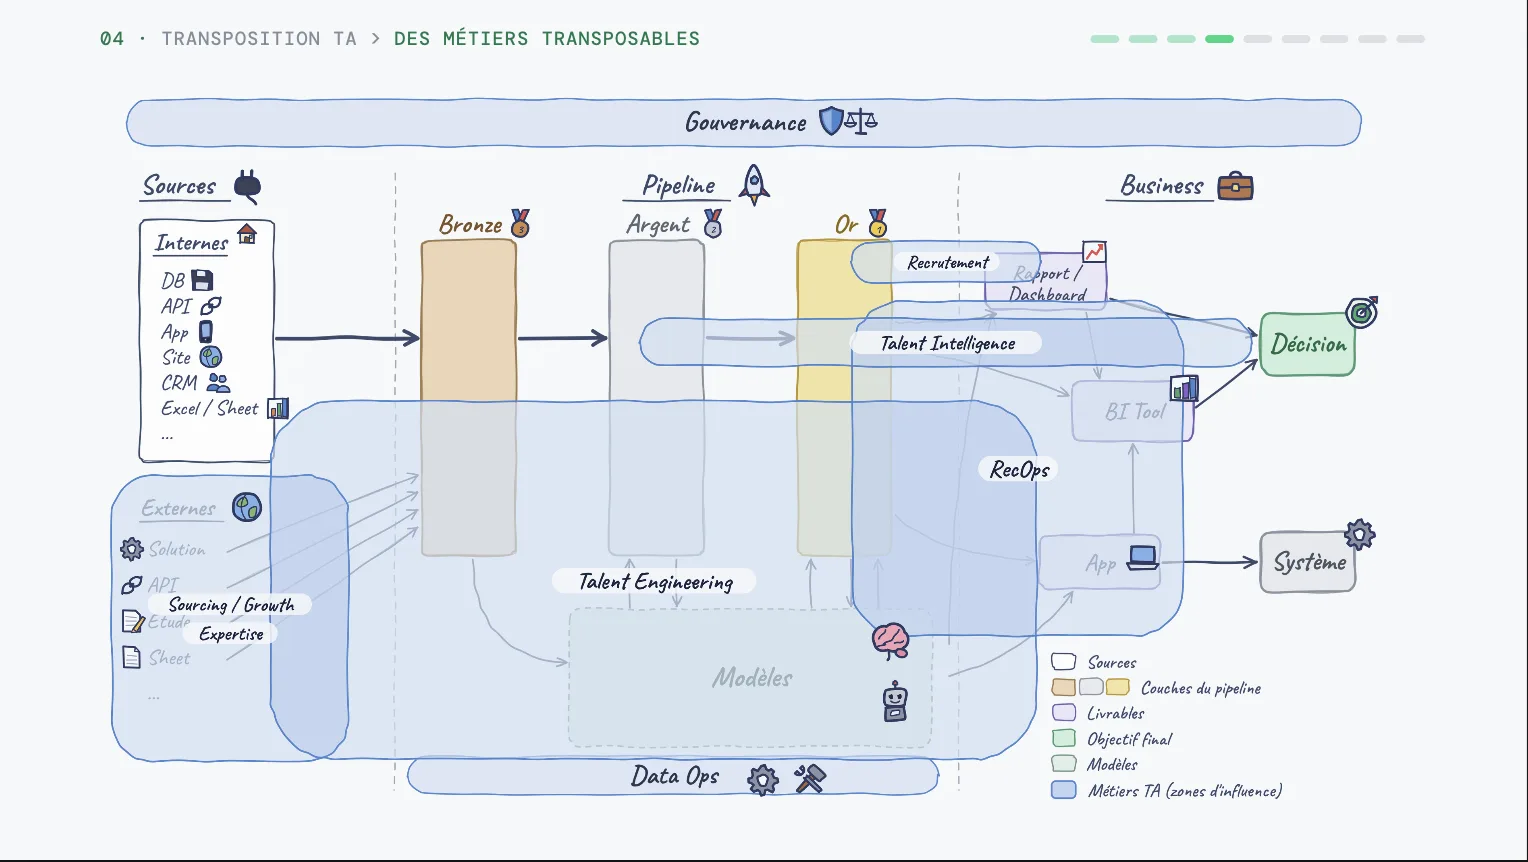
Chaque métier couvre une zone de la chaîne : le sourcing en amont sur les sources externes, le talent engineering sur le pipeline, le RecOps et la talent intelligence du côté du business. La gouvernance et les DataOps traversent tout.
La méthode, elle, tient en quatre piliers.
Own your data. La donnée est un capital, et on ne capitalise pas sur ce qu’on ne possède pas. Consommer des sources externes, c’est faire de l’Airbnb, à la nuit, au coup par coup. Posséder, c’est les intérêts composés. Une plateforme est une source, pas une stratégie. Ce qu’on refuse en possédant : les filtres qu’on n’a pas choisis, l’algorithme qui pousse autre chose, la hausse de prix sans recours, les quotas, le bannissement. Ce qu’on gagne : ses propres règles, et le droit de redéfinir ses filtres et ses paramètres du jour au lendemain. Se réapproprier la donnée, c’est se réapproprier son métier, et c’est là que la talent intelligence se débloque : on ne prend plus les commandes, on devient business partner.
Understand your data. C’est ici qu’il pose sa construction la plus neuve, celle que je retiens, et elle commence par un rôle : le recruteur traducteur, celui qui tient le knowledge. Son outil est le talent data catalog, autrement dit la couche argent du recrutement, un référentiel et une source de vérité unique avec une grille de lecture unifiée, en six étages. L’inventaire des outils et de leur contenu, parce qu’un modèle branché sur vos données commence toujours par demander de quoi on parle. Le glossaire et ses synonymes, noms de produits dépréciés compris : si un candidat emploie encore l’ancien nom, il fait bien la chose, il n’a pas mis l’information à jour. La taxonomie, les arbres d’appartenance : Next.js dans React, React dans JavaScript. L’ontologie, qui va plus loin : un framework de test poussé en interne implique le langage, une organisation produit implique un alignement tech-produit. Les règles métier de l’équipe, écrites une fois. Et la couche sémantique, le sens partagé.
Quand la salle objecte que ce ne sont que des mots, il répond que non, ce sont des embranchements : avec deux mots bien placés, on comprend l’organisation entière. Le corollaire est immédiat pour nous. Une taxonomie se juge à la granularité qu’elle permet d’atteindre, et aux traces qu’elle permet de compter. On requête la feuille, pas la racine.
Son exemple de règle métier est minuscule et vaut tout le pilier : son équipe contactait des candidats qui se révélaient freelances, pour certains, en fin de conversation, sans trace de ce statut sur le profil. Dénominateur commun, la plupart partageaient proactivement leur numéro de téléphone. La règle entrée au workflow : quand un candidat donne spontanément son numéro, lui demander s’il veut un CDI. Problème réglé. Si tu le décris, tu le donnes à ta machine.
Serve the business. L’intake est une analyse métier. Entre ce que dit le manager et la réalité, il y a un monde. Il faut y arriver avec une cartographie plus large que celle qu’on va vous tendre, et savoir combien de personnes sont réellement atteignables. Puis vient la restitution, qui est de la data analyse : rendre la donnée exploitable, et s’engager sur des moyens plutôt que sur un résultat, parce que tout ce qui se passe après la remise ne vous appartient plus. On ne livre pas des CV : on livre, on facilite et on conseille des décisions. Plus largement, co-construire des projets de recrutement qui ont du sens.
Build the system. Tout ce qui existe aujourd’hui est de l’artisanat, dit-il, et l’artisanat est une bonne chose, mais il faut savoir le projeter à grande échelle, l’élever au rang d’ingénierie. L’outil ne fait pas la stratégie, la stratégie fait le système. Et dans ce système, les briques techniques sont des réponses interchangeables : la valeur tient aux règles métier et au référentiel. Quelle que soit la solution qu’il branche dessus, maison ou achetée, c’est son référentiel qu’il y plugge, et la traduction se fait bien. Les briques critiques dont le métier dépend, ATS, CRM, base de données, il les conseille maintenues et disponibles, open source ou payantes. Autour, de la flexibilité, de la modularité, de la personnalisation métier : l’outillage et les connexions se construisent à sa main.
Pour y aller, cinq marches : preuve de concept, MVP, automatisation, échelle, orchestration. Avec le droit de s’arrêter en route, et souvent le MVP suffit, un outil que l’équipe sait lancer et qui marche. La marche à ne pas franchir trop tôt est l’automatisation : automatiser une étape dont on n’est pas sûr met le désordre dans tout l’aval. L’orchestration, il la réserve aux organisations data qui utilisent des outils data : presque personne n’en est là.
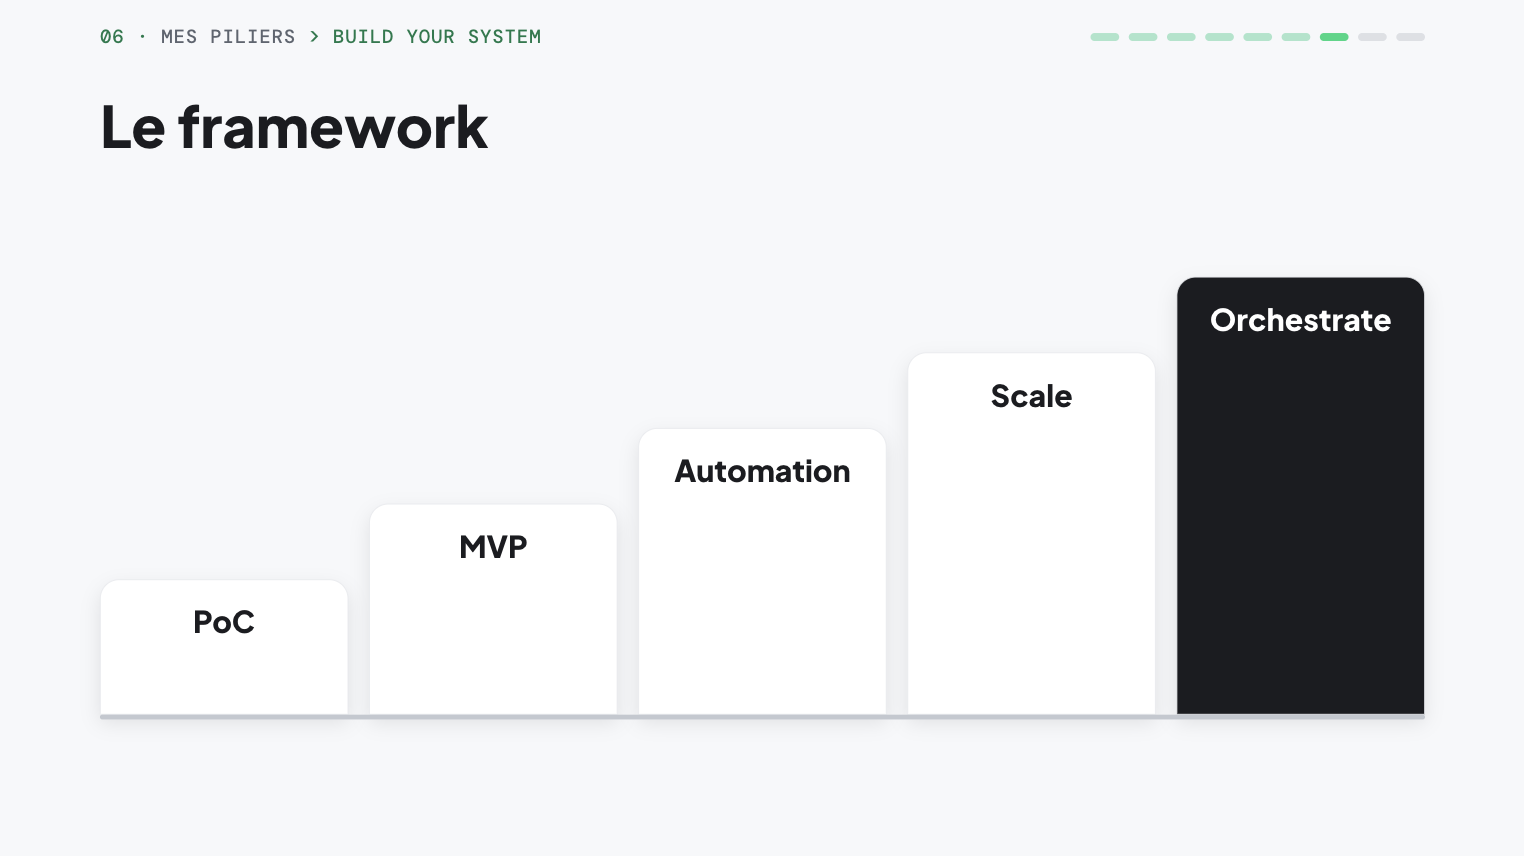
Preuve de concept, MVP, automatisation, échelle, orchestration.
Reste son principe préféré : rester le plus simple possible. Utiliser pour ce qu’elle permet de créer, pas décider, ramené au traitement de donnée, c’est co-écrire la règle scriptée qui sera reproductible et robuste avec toujours le même livrable, plutôt que de lui préférer un MCP.
Dans ce système, l’IA tient cinq places. Dans le build, un assistant de conception. Dans le système, le déterministe d’abord : beaucoup de ce qu’on confie à un modèle se répond en binaire par du logiciel, qui coûte moins cher et ne varie pas. En exploratoire, pour trouver des modèles dans de la donnée propre, et ce qu’elle a trouvé une fois, on le fige en code, c’est ça capitaliser. Au quotidien, l’orchestration : une interface, des connecteurs, et on lui fait envoyer un mail, mettre à jour le CRM, sortir le compte rendu d’entretien. En produit, le self-service et le transcript. Sa règle au-dessus des cinq tient en un mot, développer : on capitalise dessus, c’est plus fiable et moins cher.
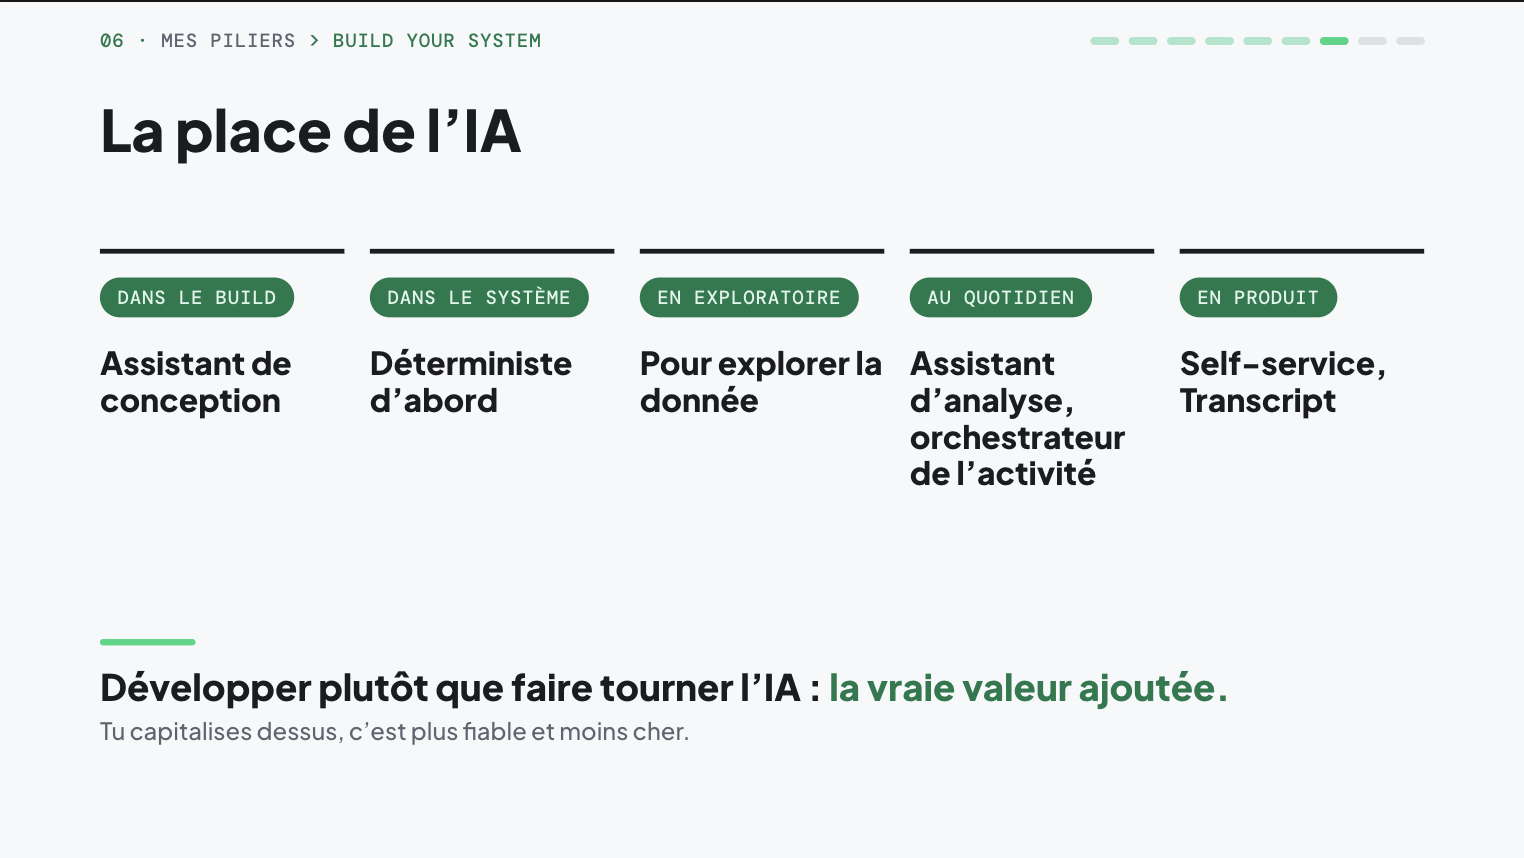
Dans le build, dans le système, en exploratoire, au quotidien, en produit.
Dernier avertissement, pour le vocabulaire des éditeurs : le vibe coding, à l’origine, c’était développer à coups de mots simples en gardant ce qui semble marcher, sans jamais challenger. Quand une solution vous parle de vibe sourcing ou de vibe recruiting, posez-vous les bonnes questions.
La conformité se démontre
Liu-Ly, juriste en propriété intellectuelle avec deux cursus récents en intelligence artificielle puis en données personnelles, a posé le cadre en une douzaine de minutes. Elle résume sa thèse en trois verbes : anticiper, démontrer, inspirer confiance.
Elle sépare d’abord deux textes qu’on confond. Le RGPD, de 2018, est un droit des personnes concernées, et il est technologiquement neutre, ce qui explique qu’il absorbe l’IA sans réécriture. L’IA Act, adopté en 2024 et recalendarisé cette année par l’AI Digital Omnibus, est une législation produit : il classe le recrutement à haut risque.
Une donnée publiquement accessible n’est pas libre de droit. Sur un réseau professionnel non plus. La collecte doit respecter la licéité, la finalité, la minimisation, la transparence et les droits des personnes.
Faire appel à un prestataire n’exonère de rien : le responsable de traitement donne les instructions, mais il vérifie aussi que son sous-traitant présente des garanties suffisantes. J’ai posé la question de l’argumentaire qu’on lit dans les conditions d’utilisation des solutions de sourcing, celui qui dit en substance nous ne détenons pas la donnée, nous ne l’hébergeons pas, nous ne sommes qu’un fournisseur de technologie. La réponse est nette : ils traitent bien, et la CNIL peut sanctionner les deux acteurs, chacun à sa mesure. Un data broker installé hors de l’Union n’est pas exempté non plus, dès lors qu’il traite les données de personnes qui se trouvent sur le territoire.
Le précédent qu’elle cite est une ESN sanctionnée cette année, non pour avoir refusé d’effacer, mais pour n’avoir pas informé les demandeurs que leurs données l’avaient bien été. Le plafond, lui, ne se discute pas : jusqu’à 4% du chiffre d’affaires mondial, ou 20 millions d’euros.
D’où la conformité dès la conception, et d’où son deuxième verbe. La valeur d’une donnée tient à sa fiabilité et à sa traçabilité autant qu’à sa disponibilité, son volume ou sa qualité. Cartographier, documenter, tracer. La documentation est un outil de gouvernance, ce qui referme la boucle sur le talent data catalog : le même travail sert à chercher et à se défendre.
Après le greenwashing et l’AI washing, elle nous laisse le compliance washing : une conformité affichée et non démontrée, et qui vend très bien. Patrick a bouclé à sa façon. Un juriste qui dit oui ou non en bout de chaîne ne fait pas le travail. Leur métier, c’est de nous aider à aller chercher du gris le plus loin possible, même si ça reste du gris.
Pour finir
L’intervention a duré près d’une heure et demie, la partie juridique une douzaine de minutes, et la soirée s’est prolongée autour d’un verre.
Le recrutement n’est pas en train de devenir une fonction data : Patrick a conclu là-dessus et je le suis, il l’a toujours été. Ce qui change, c’est que les moyens de le faire sont à notre portée, et qu’il reste à les prendre. Avec la donnée, on est dans le contrôle, on va plus vite et plus loin, et on a l’ownership de son métier et de son expertise. Tout est accéléré, mais accélérer ne veut pas dire aller vite : ça veut dire tout maîtriser.
Il l’a dit plus durement que je ne l’écrirais : si vous avez peur d’être remplacé par l’IA, vous le serez probablement. Cette peur suppose la vision du métier qu’il avait retirée à la salle en ouverture, celle du recruteur qui n’existe que sur la couche or. Avec l’autre, l’IA est un outil, et ce qu’on lui donne à manger, c’est son propre travail. Les places à prendre ont des noms : expert sourcing, talent engineer, analyste talent.
Merci à Patrick Dos Santos pour une intervention charpentée, généreuse en terrain et avare en marketing. Merci à Liu-Ly d’avoir rendu le cadre juridique utilisable plutôt que menaçant. Merci à Ideuzo de nous accueillir à nouveau. Et merci à ceux qui étaient là pour les questions, qui ont fait la moitié de la soirée.
Corpus · envois mensuels
Lire la suite par email.
Sourcing, méthode, gouvernance. Un envoi par mois, jamais plus. Articles longs, sans script ni sponsor. Désinscription en un clic.